
約4分で読めます
Operation
KINTO FACTORY ローンチ半年記念:挑戦と学びの軌跡

要約を読む
リリース準備の負担が大きかったことが問題でした。 毎回1から準備をしなければならず、手順書の確認や修正が煩雑で、1回のリリースに平均で3時間以上かかっていました。 そこで、リリース手順書をコード管理システムに移行し、バージョン管理とテンプレート化を実施しました。 その結果、準備時間は60%削減され、1回のリリースにかかる時間は平均2時間に短縮されました。 インシデントが毎日のように発生していたことが課題でした。 ローンチ後3日間で10件のインシデントが発生し、その多くはユーザーに影響がないものでした。 アプリケーションのエラーハンドリングが不十分だったため、すべてをクリティカル扱いにしていたのが原因でした。 そこで、影響がないエラーは出力を見直し、修正が難しい場合は通知を除外するルールを導入しました。 その結果、インシデントの発生件数は半分にまで減少し、毎日1件未満にまで抑えられました。 インシデント対応の初動に時間がかかっていたこともありました。 メンバーの認識がバラバラで、PagerDutyの操作に慣れていないため、ステータス更新が漏れたりもしました。 そこで、Slackにワークフローを定義し、コマンドで対応を開始できるようにしました。 また、全員で集まってモブ作業を行うようにし、対応の認識を共有しました。 その結果、アラートから対応開始までの時間が10分から1分未満に短縮されました。 運用のスタートから半年で、3つの大きな課題を解決しました。 リリース準備、インシデント検知、対応フローの3点で改善が見られました。 特に、インシデ分の件数は半分に、対応時間は10分から1分にまで短縮されました。 この改善はメンバーの経験や知識の差を補うことで実現できました。 今後もKINTO FACTORYの運用を安定させながら、ユーザーに安心して使えるサービスを提供していきます。
AI が生成した要約です。正確な内容は本文をご確認ください。
はじめに
こんにちは、KINTO FACTORY のバックエンドエンジニアをしている西田です。
KINTO FACTORY をローンチして早いもので半年が経ったので、サービス運用を開始してからリリースやシステム監視を中心に遭遇した課題や、私たちが学んだことをみなさんと共有したいと思います。
KINTO FACTORY について
はじめに KINTO FACTORY のサービス概要を少しだけ。
お乗りのクルマに適合するハードウェア・ソフトウェアといった機能やアイテムをアップデートできるサービスとなります。
これまでのクルマのアップデートはディーラーでの作業が必要であったり、いわゆるメーカーオプションのような注文時にしか選択できないアイテムを KINTO FACTORY ではウェブ上から申込みができます。
また、KINTO 契約車両だけでなくトヨタ/レクサス/GRのクルマが対象となっており、適合するクルマであればアップデートを行うことができます。
今年の夏にローンチし、半年が経過しようとしています。
運用について
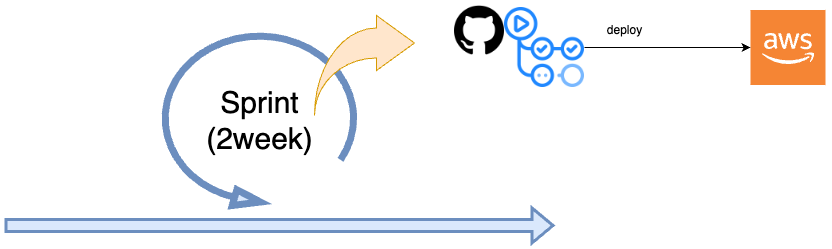
リリースは2週間に1回のペースで行い、GitHub Actions をメインに CI/CD を構築してデプロイしています。
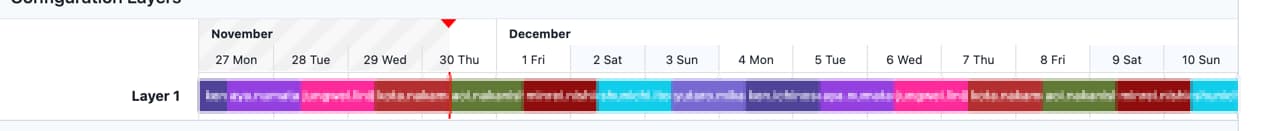
サービスの監視は、運用チームといった専用の組織を設けずに開発メンバーが中心となり、当番を回して運用をしています。
ローテーションは PagerDuty のスケジュール機能を利用しています。
また、インシデントの検知は次のようなイメージで構成されています。
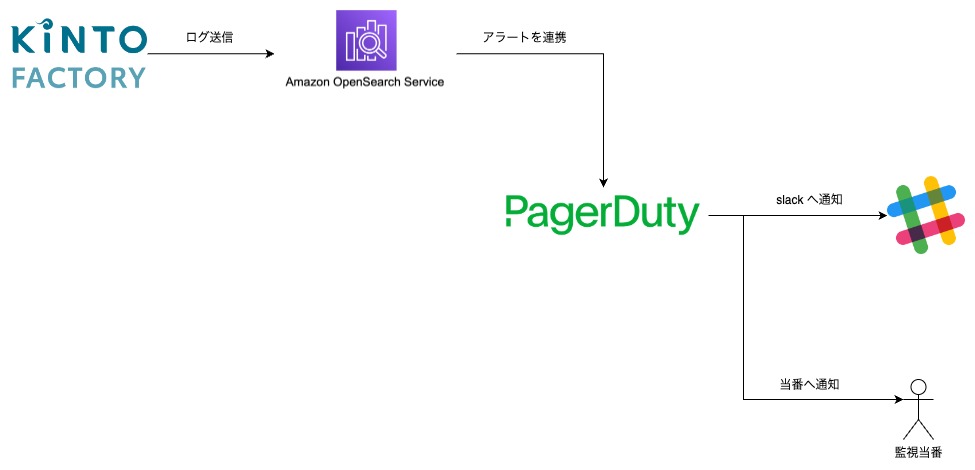
アプリケーションログやサービス監視の情報を OpenSearch に連携し、ユーザー影響を判断して PagerDuty に通知が行われます。(画像は対応完了後のものです)
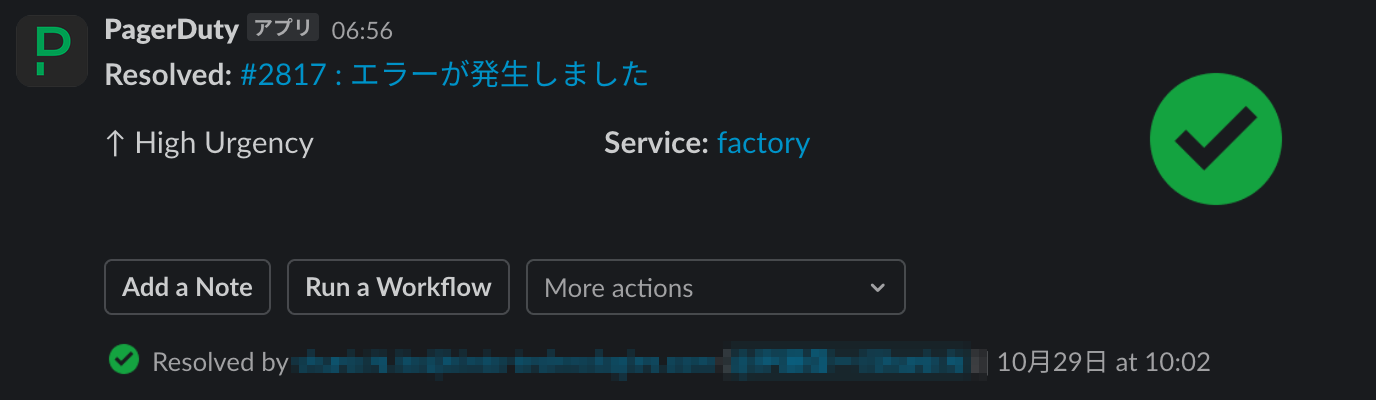
その後 Slack にも通知がされることで監視当番が対応を行います。
基本的には担当者が対応しますが、必要に応じて有識者を巻き込んで対応をするようにしています。
また、対応者だけでなくチームとして把握ができるように翌日のデイリースクラムで対応内容を共有しています。
課題と対応
運用を始めてから遭遇した課題と、それをどのように対応したかを共有します。
リリース準備の負担が大きい
テンプレート化されていないこともありリリースのたびにデプロイのための準備を1から行っていて、粒度も統一されておらず時間がかかっていました。
中でもリリース手順書周りは Confluence ベースで管理していて、手順の確認や修正が煩雑でした。
⇒ リリース手順書をコード管理へ移行することで、バージョン管理やテンプレート化、差分確認をできるようにすることで、リリース準備の負担を軽減することができました。
インシデント検知が多発
ローンチ後、数日間のインシデントの件数が↓の通りで
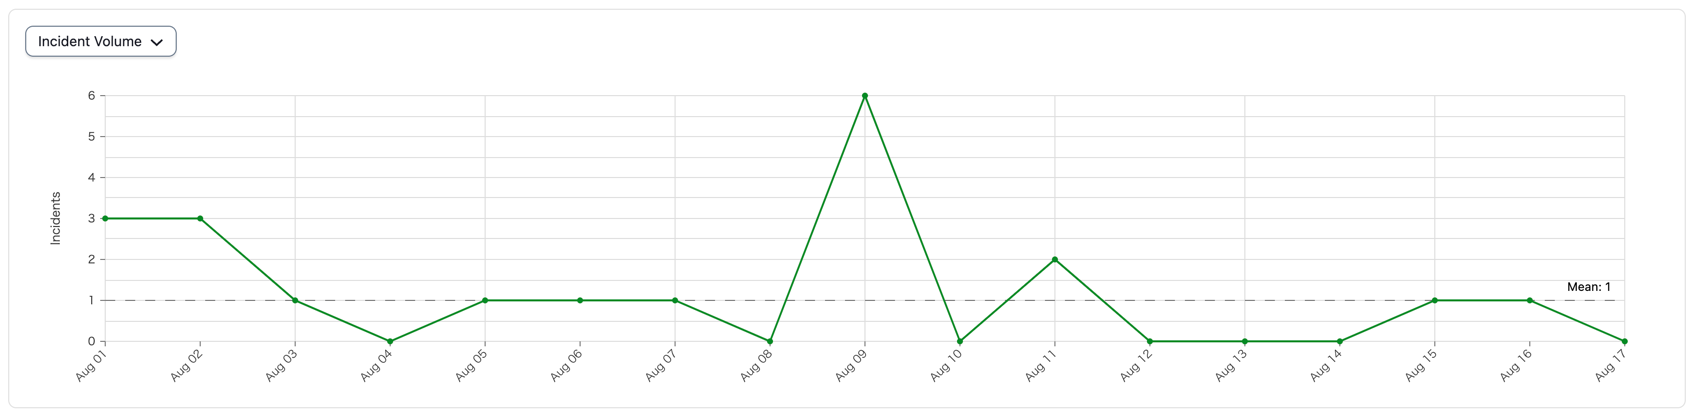
アプリケーション側のエラーハンドリング設計が甘かったため、ユーザー影響がないものであってもクリティカル扱いとして検知され、運用開始後は毎日のようにインシデントが発生し監視の負荷が大変なことに...
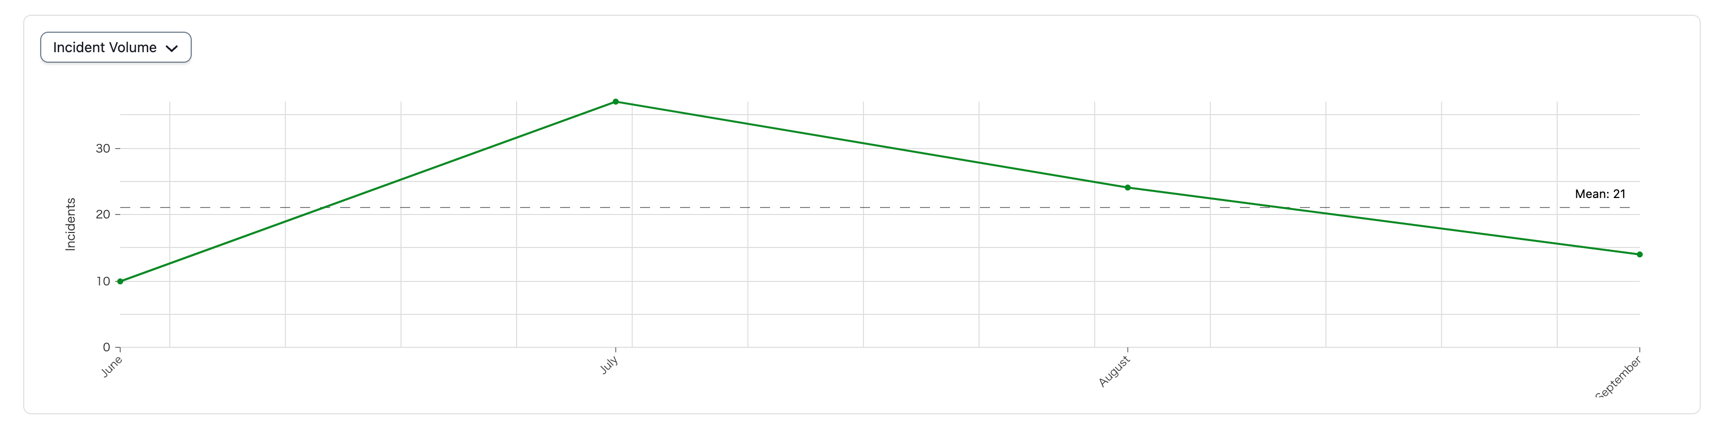
⇒ 対応するには数が多く一括で対応が難しかったため、緊急度が高くないものは出力を見直すように修正、修正がすぐできない場合は通知されないように除外設定を組み込んで最適化を図りました。
インシデント対応の初動に時間がかかる
対応フローの手順などが整っていなかったためメンバーによって認識の差があり、対処に時間がかかってしまう場面がありました。
PagerDuty の操作に慣れていないこともあり確認済みステータスへの更新が漏れてたりも。。。
⇒ Slack でワークフローを定義して、コマンド入力でインシデント対応を開始して手順に沿って対応が進められるように環境を整えて改善を図りました。
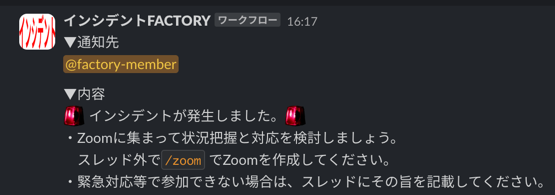
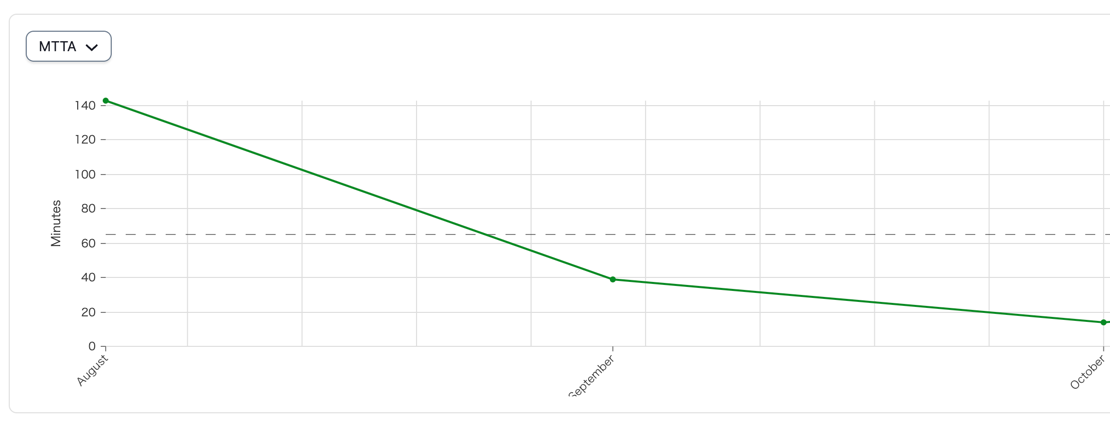
また、インシデントVSチームという構図になるようにまずは全員が集まって対応をモブ作業として行い、認識を擦り合わせながら対応をすることで、アラートが発火してから対応開始するまでの時間を1/10以下に短縮することができました。
まとめ
ローンチ直後は色んな課題が起きてバタバタな日々を過ごしていましたが、継続的に改善を行うことで少しずつ改善されてきました。
あらためてふりかえるとメンバーの経験値や知識による対応の差があったため、事前にどういった運用をしていくのかをきちんと整理しながら運用を開始することで、立ち上がりもスムーズにできたのかなと実感しました。
まだまだ改善の余地はありますが、これからもユーザーにとってより良いサービスを提供できるように運用を継続していきます!
さいごに
今回はサービス運用で遭遇した課題とその対応を共有しました。
私たちの経験が何かの参考になれば嬉しいです。
また、KINTO FACTORY では新たな仲間を募集していますので、ご興味があればぜひ下記の求人をチェックしてみてください!
関連記事 | Related Posts



We are hiring!
Follow Us
KINTOテクノロジーズの最新情報をSNSで発信中!イベント・テックブログ更新情報もお届けします。